 大模型应用场景
# 1 RAG 开发
# 1.1 概述
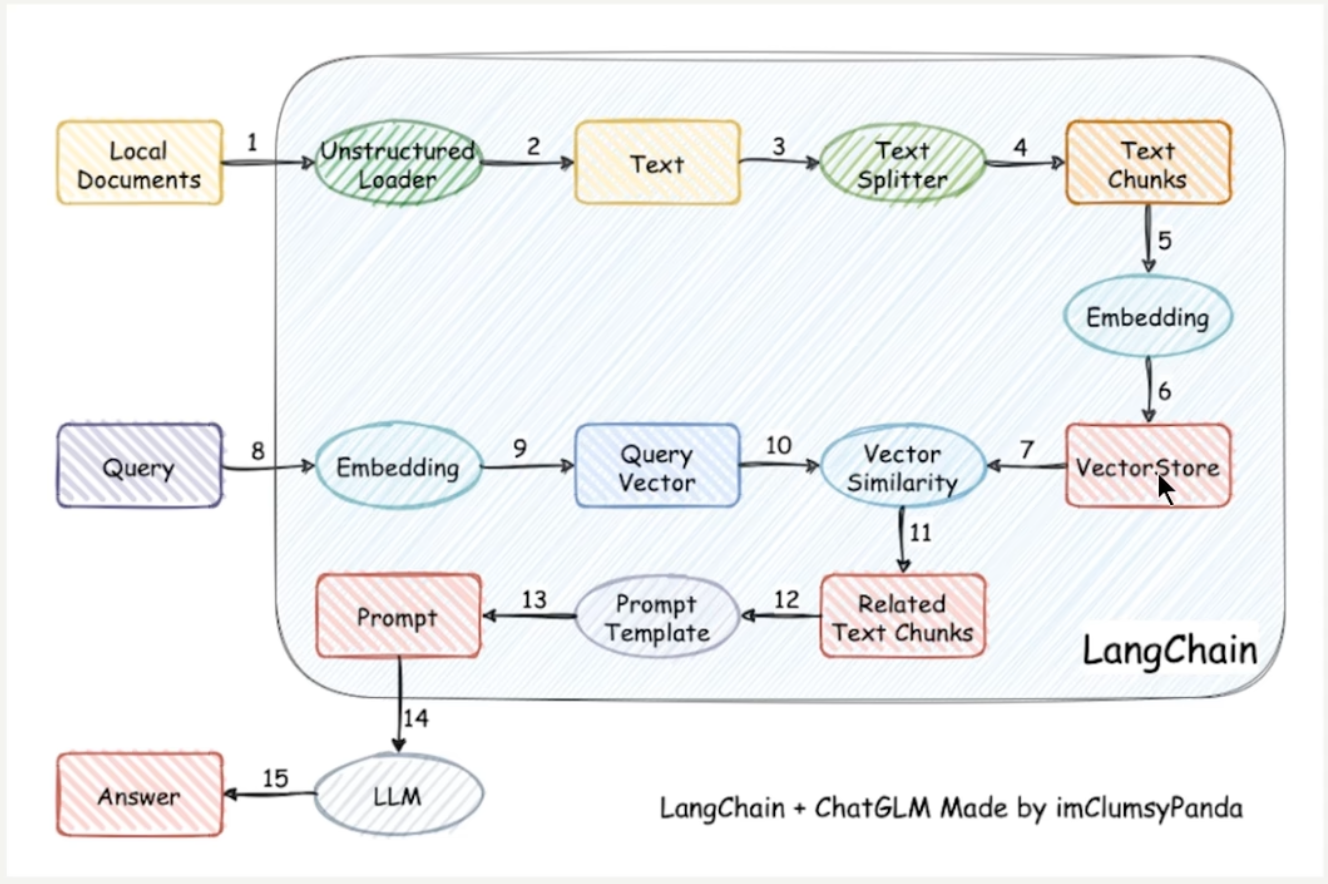
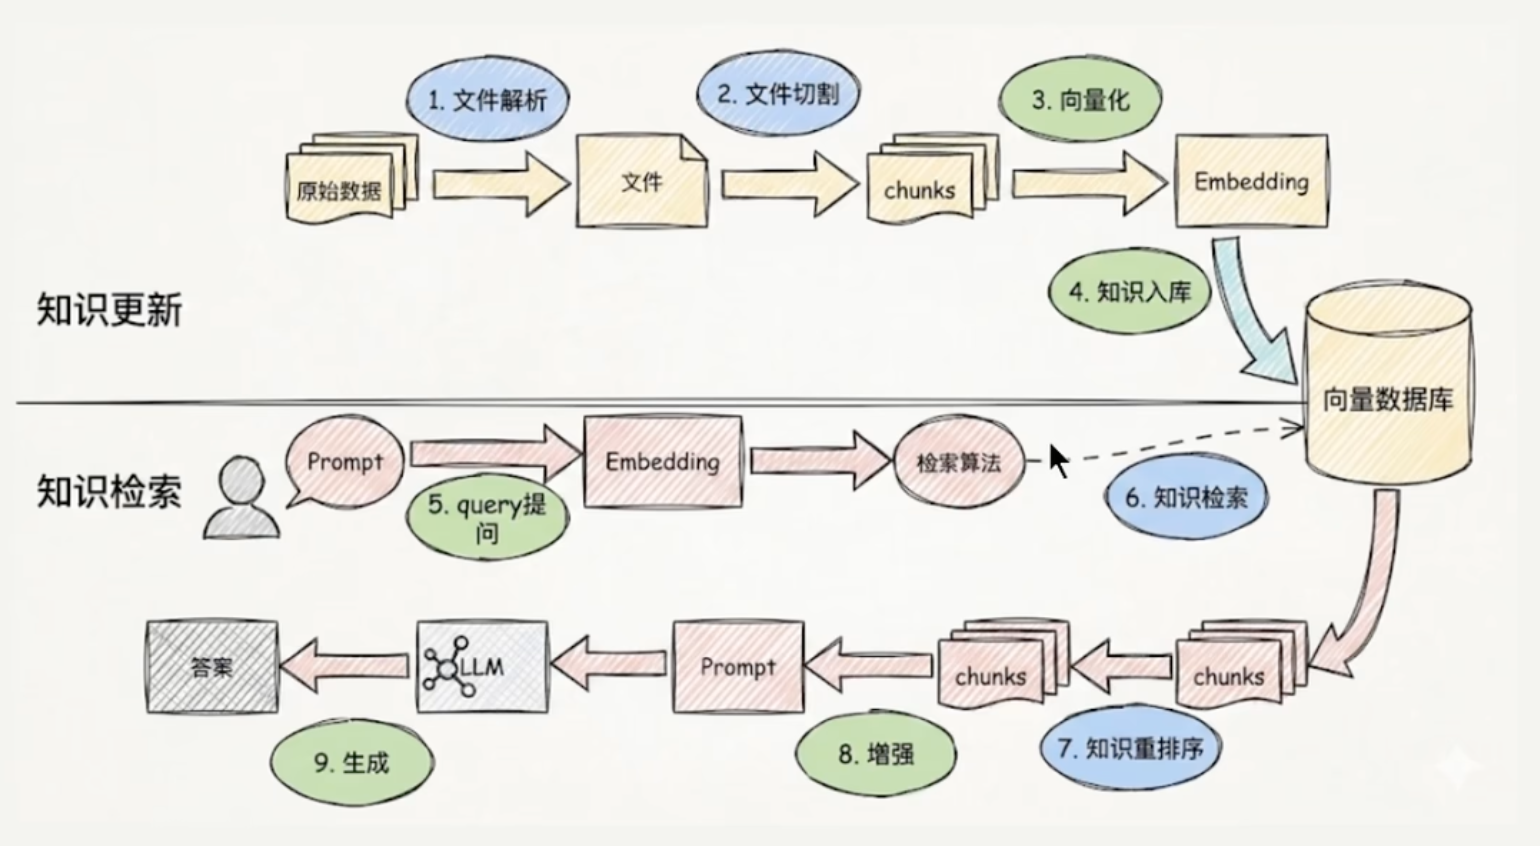
Retrieval-Augmented Generation (RAG),检索增强生成;
简单来说就是,在调用大模型之前,先进行一次知识库内容检索,再把检索的结果添加到大模型提示词中,提高大模型回答准确度。
# 1.2 难点
# 1.2.1 文件解析
# 1.2.2 文件切割
# 1.2.3 知识检索
# 1.2.4 知识重排序
# 2 Agent 开发
# 2.1 概述
充分利用 LLM 的推理决策能力,通过增加规划、记忆和工具调用的能力,构造一个能独立思考、逐步完成给定目标的 Agent(智能体)。
智能体核心要素被细化为以下模块:
大模型(LLM)作为 “大脑”:提供推理、规划和知识理解能力,是 AI Agent 的决策中枢。 大脑主要由一个大型语言模型 LLM 组成,承担着信息处理和决策等功能, 并可以呈现推理和规划的过程,能很好地应对未知任务。
规划决策(Planning):通过任务分解、反思与自省框架实现复杂任务处理。例如,利用思维链(Chain of Thought)将目标拆解为子任务,并通过反馈优化策略。
工具使用(Tool Use):调用外部工具(如 API、数据库)扩展能力边界。
记忆(Memory) 智能体像人类一样,能留存学到的知识以及交互习惯等,这样的机制能让智能体在处理重复工作时调用以前的经验,从而避免用户进行大量重复交互。
- 短期记忆:存储单次对话周期的上下文信息,属于临时信息存储机制。受限于模型的上下文窗口长 度。
- 长期记忆:可以 横跨多个会话或时间周期 ,可存储并调用核心知识,非即时任务。
- 比如,关于用户的偏好,过去执行过的指令等。
- 长期记忆,可以通过 模型参数微调(固化知识) 、 知识图谱(结构化语义网络) 或 向量数据库(相似性检索) 方式实现。
- 行动(Action):实际执行决策的模块,涵盖软件接口操作(如自动订票)和物理交互(如机器人执行搬运)。比如:检索、推理、编程等。
# 3 大模型应用开发场景
# 3.1 场景 1:纯 Prompt
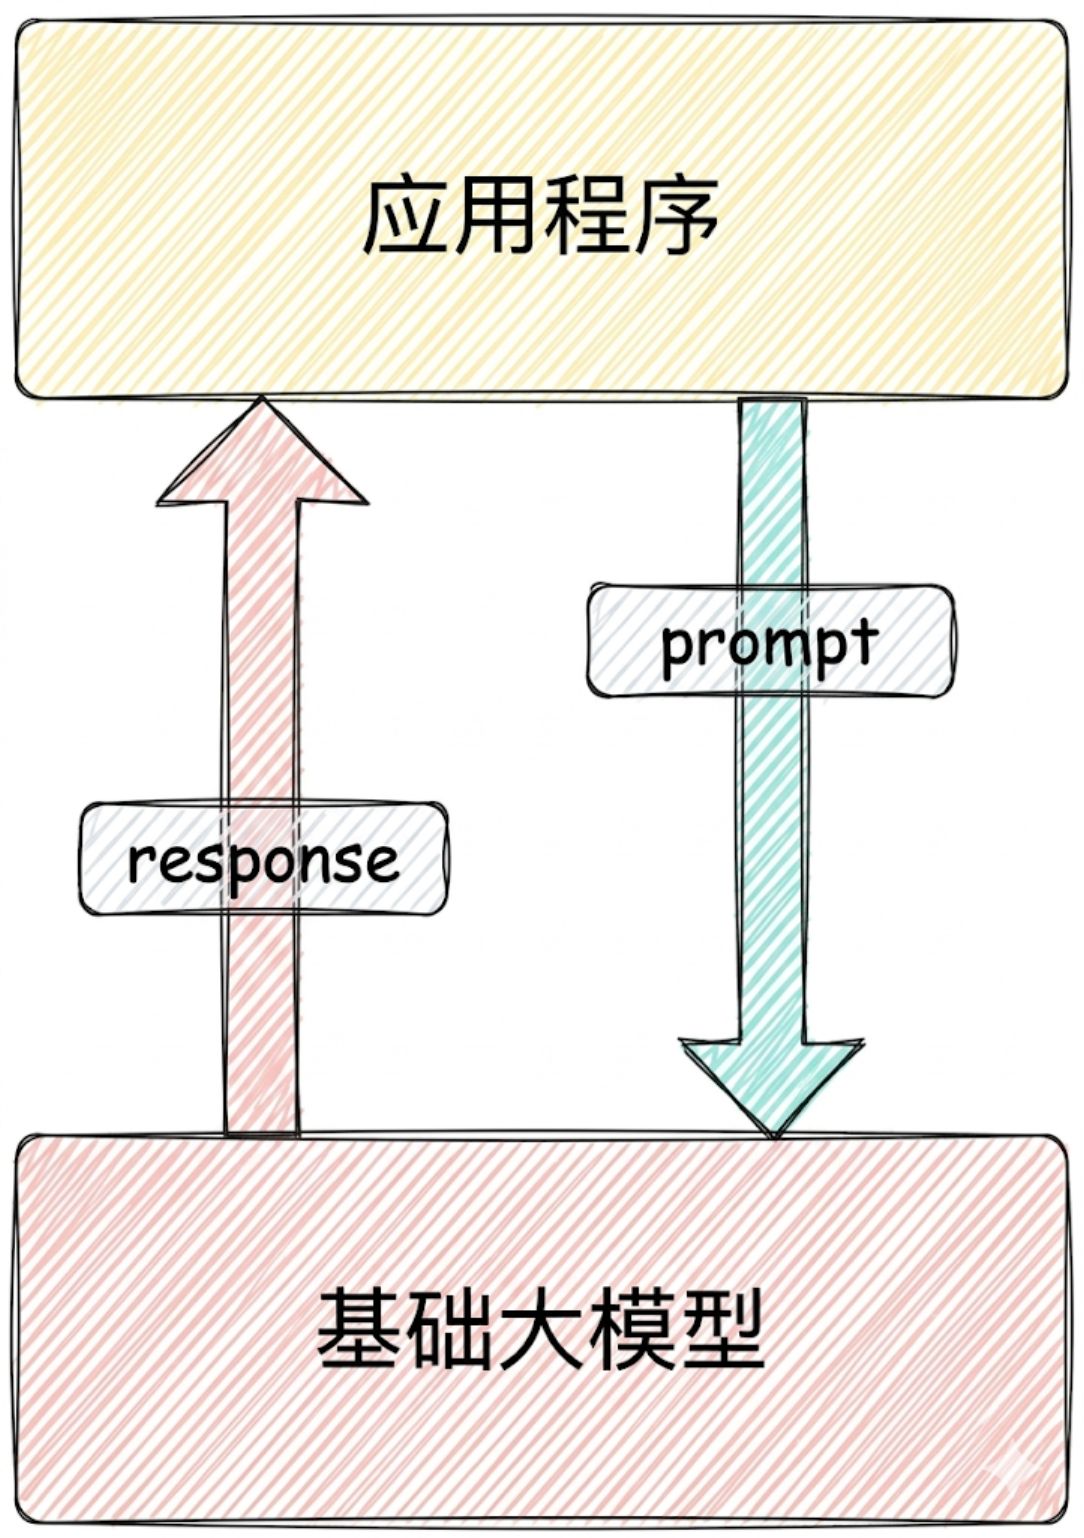
- Prompt 是操作大模型的唯一接口
- 当人看:你说一句,ta 回一句,你再说一句,ta 再回一句
- 纯粹的单次问答,无上下文记忆
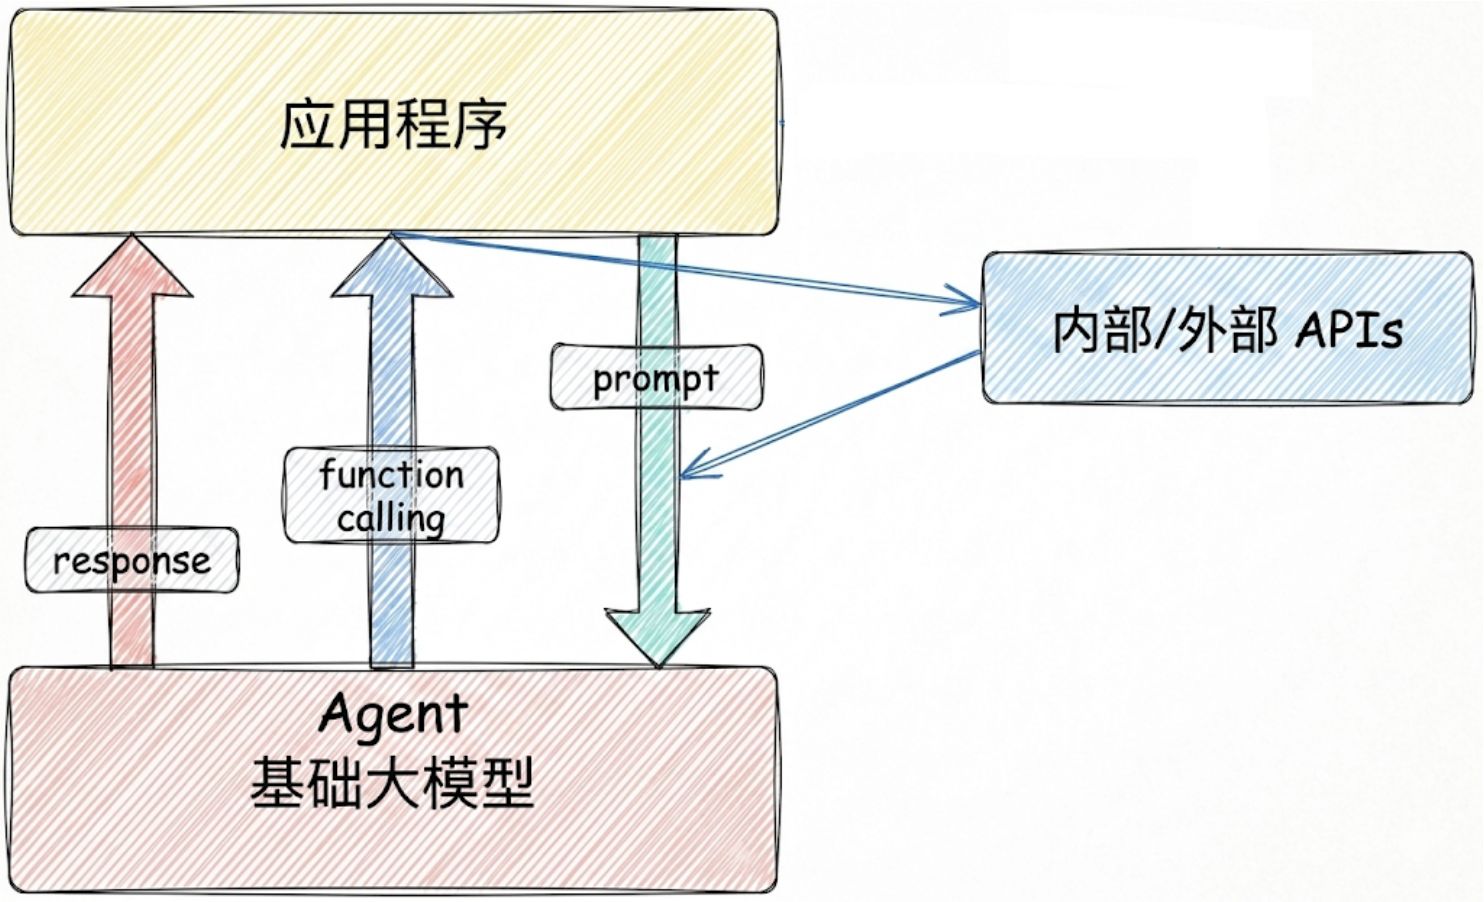
# 3.2 场景 2:Agent + Function Calling
- Agent:AI 主动提要求
- Function Calling:需要对接外部系统时,AI 要求执行某个函数
- 当人看:你问 ta「我明天去杭州出差,要带伞吗?」,ta 让你先看天气预报,你看了告诉 ta,ta 再告诉你要不要带
# 3.3 场景 3:RAG (Retrieval-Augmented Generation)
RAG:需要补充领域知识时使用
- Embeddings:把文字转换为更易于相似度计算的编码。这种编码叫向量
- 向量数据库:把向量存起来,方便查找
- 向量搜索:根据输入向量,找到最相似的向量
举例:考试答题时,到书上找相关内容,再结合题目组成答
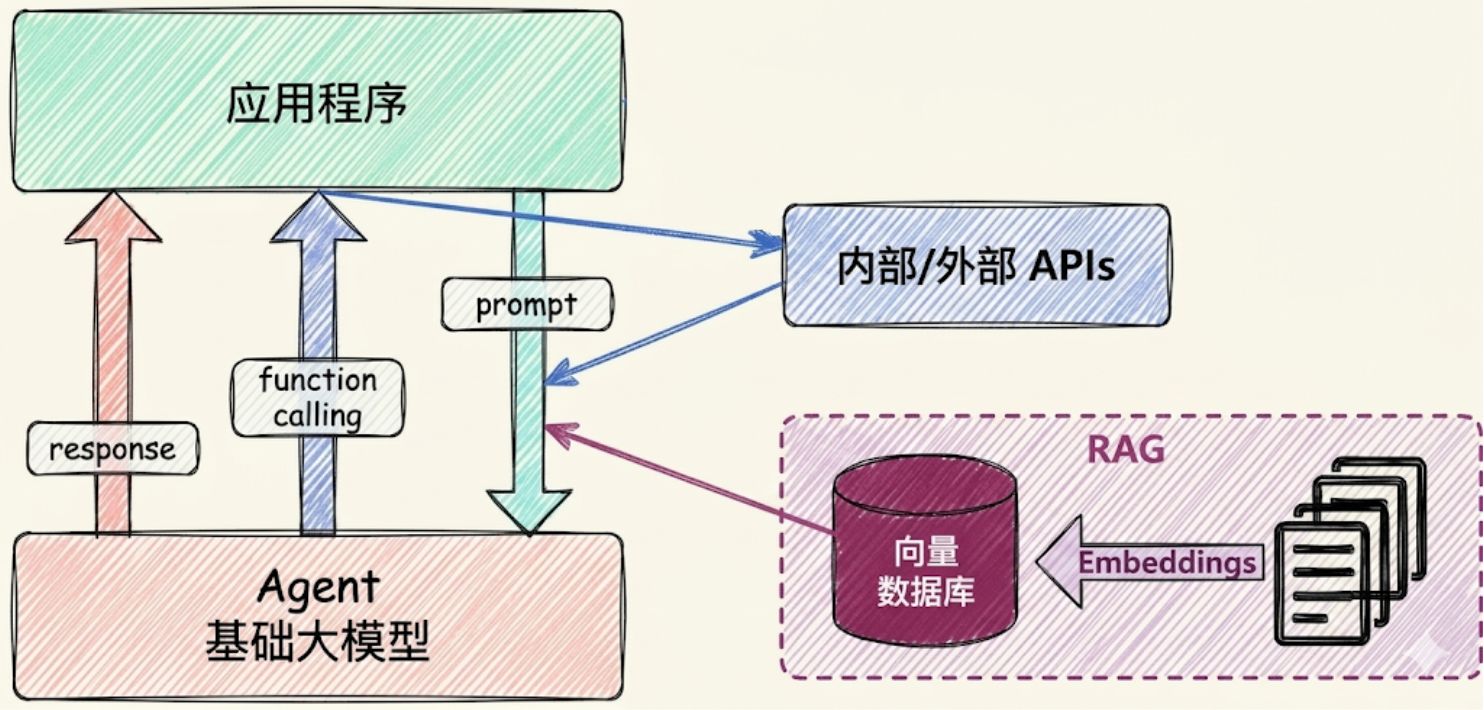
这个在智能客服上用的最广泛。
# 3.4 场景 4:Fine-tuning (精调 / 微调)
举例:努力学习考试内容,长期记住,活学活用。
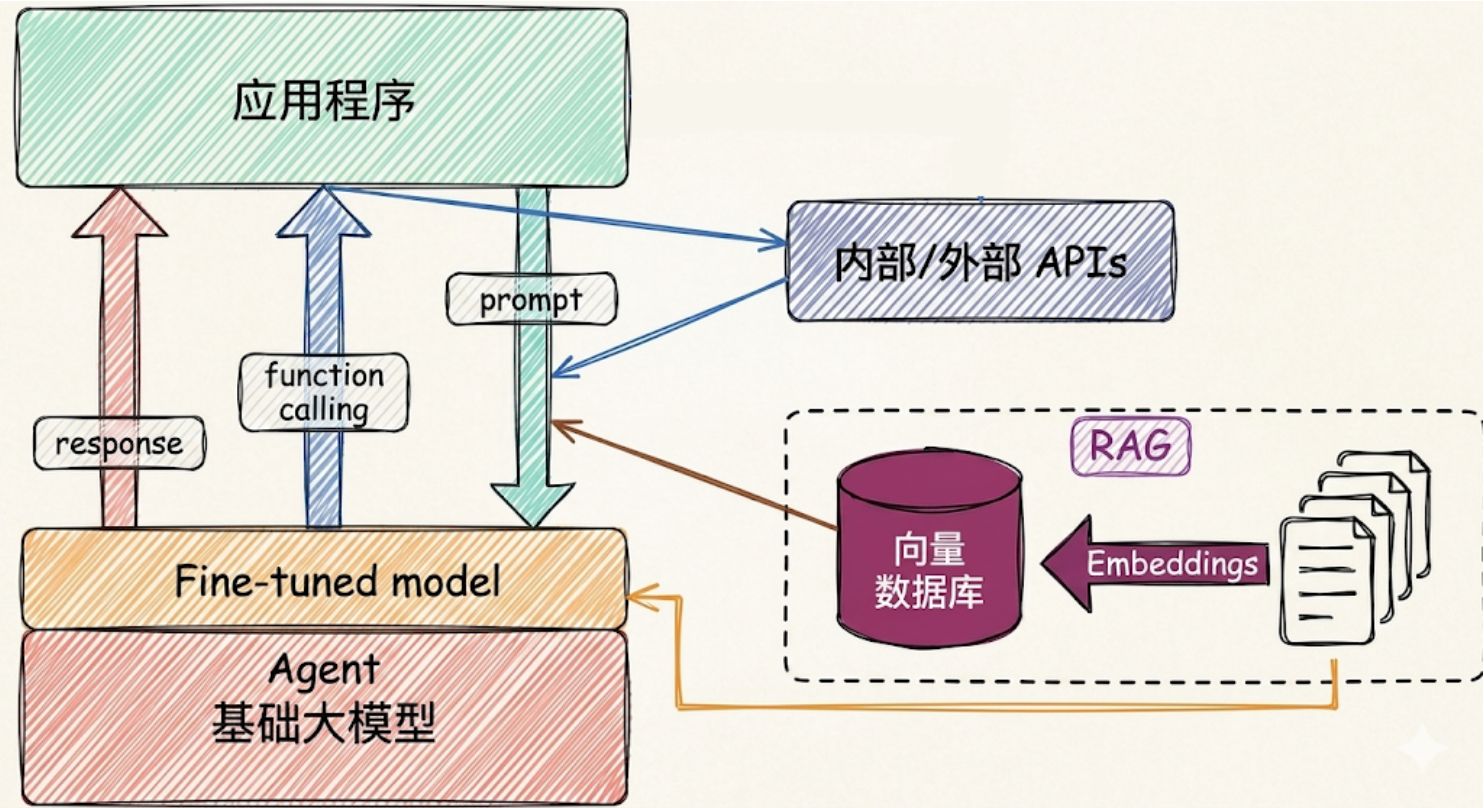 特点:成本最高;在前面的方式解决不了问题的情况下,再使用。
# 3.5 如何选择相关技术
面对一个需求,如何开始,如何选择技术方案?下面是个常用思路:
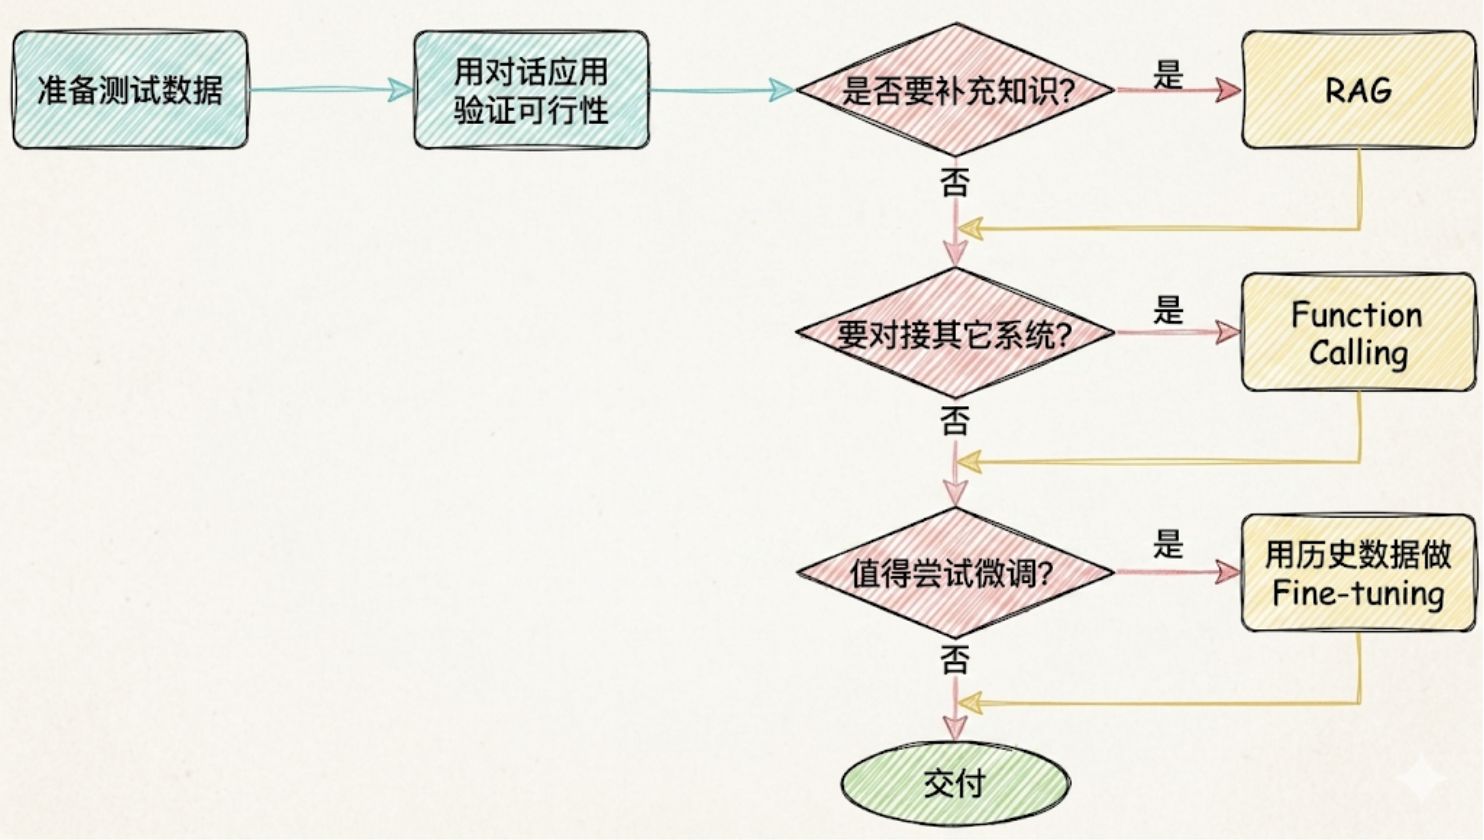
上次更新: 2026/11/08, 15:07:59